Lokale KI-Modelle im SEO-Test: Qwen gegen Claude und Co.

KI-Zusammenfassung
- Der Test vergleicht zehn lokale Qwen-Modelle mit Cloud-Modellen bei 29 typischen SEO-Aufgaben und zeigt: Das beste lokale Modell erreicht 0,77 Genauigkeit, Cloud-Modelle liegen zwischen 0,90 und 1,00.
- Lokale Modelle eignen sich für Keyword-Klassifizierung, Alt-Texte, FAQ-Extraktion und technische Aufgaben wie robots.txt, scheitern aber bei Rechenaufgaben, Content-Gap-Analysen und komplexem technischem SEO.
- Der Denkmodus bei qwen3 verbessert die Genauigkeit bei Rechenaufgaben, verlangsamt aber die Verarbeitung um bis zu 15-mal und ist daher praktisch nicht einsetzbar.
- Lokale KI-Modelle lohnen sich für Massenaufgaben mit sensiblen Daten wie Search-Console-Keywords und interne Produktdaten, während komplexe Analysen besser in Cloud-Modelle gehören.
Automatisch mit KI erstellt, die Details stehen im Artikel.
Inhaltsverzeichnis
„Können wir das nicht mit einem lokalen Modell machen?“ Diese Frage höre ich in Kundengesprächen immer öfter. Meist steckt Datenschutz dahinter: Im Juni 2026 nannte eine Marketing-Leiterin ein lokales Modell als datenschutzkonforme Alternative, „aber irgendein Spezi muss das zertifizieren“. Im Oktober erzählte mir ein Industriekunde, dass die Firmenrichtlinie Drittanbieter-Tools grundsätzlich blockiert.[6] Lokale KI-Modelle laufen auf dem eigenen Rechner oder Server, kein Text verlässt das Haus. Die Frage ist nur: Sind sie gut genug für echte SEO-Arbeit?
Ich wollte das nicht mehr aus dem Bauch beantworten. Für eine Schulung zu KI mit eigenen Daten lief auf einem Server mit Grafikkarte ohnehin Ollama, also habe ich 29 typische SEO-Aufgaben geschrieben, mit festen Sollwerten und automatischer Prüfung. Dann habe ich sie zehn lokalen Qwen-Läufen gestellt und als Vergleich Claude, Codex und DeepSeek aus der Cloud.[1] Hier sind die Ergebnisse, mit Genauigkeit, Laufzeit und den Stellen, an denen ich meine eigene Bewertung korrigieren musste.
Bestes lokales Modell (qwen3:4b-instruct)
0,77
Genauigkeit, 14 von 29 voll richtig
Kleinstes Claude-Modell (Haiku)
0,98
27 von 29 voll richtig
Schnellstes Modell (DeepSeek v4.1 Flash)
0,6 s
Median je Aufgabe, alle 29 in 18 s
Der Testaufbau: 29 SEO-Aufgaben, automatisch geprüft
Ein KI-Modelle-Vergleich ist nur so gut wie seine Aufgaben. Ich habe deshalb Aufgaben gestellt, die ich in Projekten tatsächlich an ein Modell gebe: Keywords sortieren, Snippets schreiben, technische Fehler finden, Daten aus der Search Console auswerten. Jede Aufgabe hat eine klare, prüfbare Antwort.
Die Aufgaben
Alle Daten sind erfunden: eine E-Bike-Marke namens Velora, Wärmepumpen-Ratgeber, Beispiel-URLs. So kann kein Modell die Antwort aus dem Training kennen, und es stehen keine Kundendaten im Test.[1]
| Kategorie | Aufgaben | Beispiel |
|---|---|---|
| Keywords | 5 | Suchintent zuordnen, Brand-Keywords mit Tippfehlern finden, Regex für den Search-Console-Filter |
| Snippets | 4 | Title-Tag mit höchstens 60 Zeichen, Meta Description mit 140 bis 160 Zeichen, Alt-Text |
| Texte | 6 | H2-Gliederung, Zusammenfassung in 220 Zeichen, Keyword-Stuffing erkennen, FAQ und Entitäten extrahieren |
| Technik | 8 | robots.txt lesen, hreflang prüfen, Weiterleitungskette, Sitemap, Canonicals, JSON-LD |
| Analyse | 6 | CTR-Potenzial rechnen, Quick Wins, Kannibalisierung, doppelte Titles, interne Links, Content-Gap |
Die Modelle und die Hardware
Die lokalen Modelle liefen über Ollama auf einem Cloud-Server mit einer Nvidia Tesla T4 (16 GB Grafikspeicher). Das ist eine ältere Rechenzentrumskarte, etwa auf dem Niveau einer guten Gaming-Grafikkarte. Getestet habe ich die Qwen-Familie von Alibaba, weil sie auf Deutsch ordentlich arbeitet und in vielen Größen vorliegt: qwen2.5 mit 0,5, 1,5, 3, 7 und 14 Milliarden Parametern sowie qwen3 mit 4 und 8 Milliarden, jeweils mit und ohne Denkmodus. Dazu kam qwen3:30b-a3b, ein Mixture-of-Experts-Modell mit 30 Milliarden Parametern, von denen je Token nur rund 3 Milliarden rechnen. Es ist mit 19 GB zu groß für die Karte, Ollama lagert den Rest automatisch in den Arbeitsspeicher aus.[4]
Auf der Cloud-Seite liefen Claude Haiku, Sonnet und Opus sowie drei Codex-Modelle (gpt-6-luna, gpt-6.1-terra, gpt-6.2-sol), alle über die Abos und deren Kommandozeile, ohne Werkzeuge und ohne eigene Systemanweisung. DeepSeek v4.1 Flash und v4 Pro liefen über eine OpenAI-kompatible API. Jede Aufgabe lief einmal je Modell, mit Temperatur 0.[1][5]
So wird bewertet
Jede Aufgabe hat eine eigene Prüfung im Code, die einen Wert von 0 bis 1 vergibt. Listen werden per F1-Wert verglichen, also halb richtig gibt halbe Punkte. Bei Snippets zählt das Skript die Zeichen, bei JSON-LD prüft es die Struktur, bei Rechenaufgaben die letzte Zahl der Antwort. Die Sollwerte habe ich gegen die Google-Dokumentation geprüft, die CTR-Werte stammen aus meiner Keyword-Studie 2026.[2][3][7] „Genauigkeit“ ist der Mittelwert über alle 29 Aufgaben, „voll richtig“ zählt die Aufgaben mit Wert 1.
Alles liegt offen auf GitHub: jede Frage, jede Musterantwort, jede Prüfregel als Code, alle 522 Antworten und eine Anleitung, mit der du den Test auf deiner eigenen Hardware wiederholen kannst. Zum Repository seo-llm-bench
Ergebnisse: lokale KI-Modelle gegen Cloud
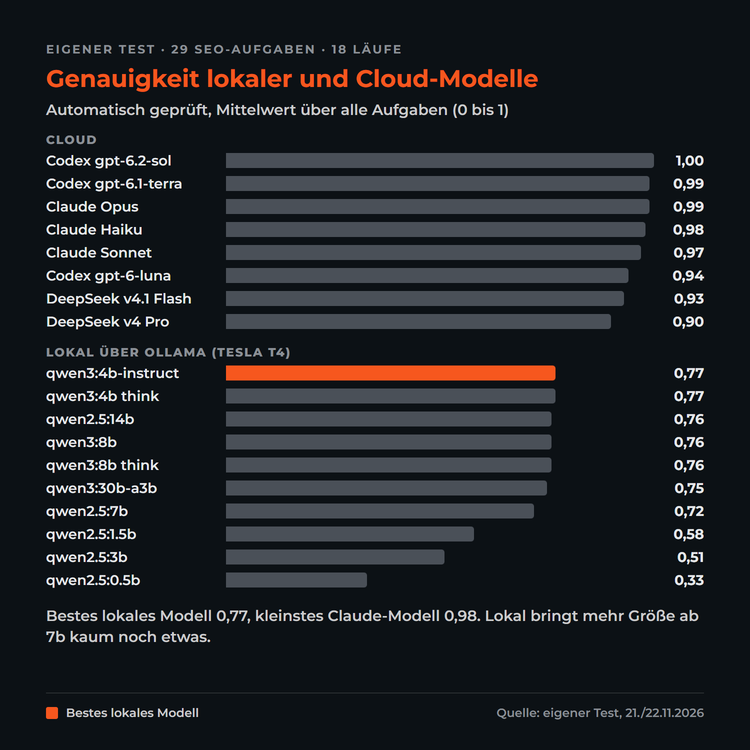
Das Ergebnis ist eindeutig. Die Cloud-Modelle liegen zwischen 0,90 und 1,00, die lokalen Modelle höchstens bei 0,77.[1]
| Modell | Genauigkeit | Voll richtig | Median je Aufgabe |
|---|---|---|---|
| Codex gpt-6.2-sol | 1,00 | 29 | 5,3 s |
| Codex gpt-6.1-terra | 0,99 | 28 | 4,7 s |
| Claude Opus | 0,99 | 28 | 4,1 s |
| Claude Haiku | 0,98 | 27 | 3,3 s |
| Claude Sonnet | 0,97 | 26 | 3,5 s |
| Codex gpt-6-luna | 0,94 | 26 | 5,2 s |
| DeepSeek v4.1 Flash | 0,93 | 24 | 0,6 s |
| DeepSeek v4 Pro | 0,90 | 23 | 0,7 s |
| qwen3:4b-instruct (lokal) | 0,77 | 14 | 2,7 s |
| qwen3:4b mit Denkmodus (lokal) | 0,77 | 19 | 41,9 s |
| qwen2.5:14b (lokal) | 0,76 | 17 | 3,9 s |
| qwen3:8b (lokal) | 0,76 | 15 | 3,3 s |
| qwen3:8b mit Denkmodus (lokal) | 0,76 | 20 | 14,8 s |
| qwen3:30b-a3b (lokal) | 0,75 | 15 | 3,7 s |
| qwen2.5:7b (lokal) | 0,72 | 15 | 2,8 s |
| qwen2.5:1.5b (lokal) | 0,58 | 9 | 2,5 s |
| qwen2.5:3b (lokal) | 0,51 | 8 | 2,6 s |
| qwen2.5:0.5b (lokal) | 0,33 | 3 | 2,3 s |
Drei Dinge fallen mir an der Tabelle auf. Erstens liegen zwischen dem besten lokalen und dem schwächsten Cloud-Modell 13 Punkte, zum kleinsten Claude-Modell sogar 21. Zweitens bringt mehr Größe lokal ab 7 Milliarden Parametern kaum noch etwas: Das 14b-Modell ist doppelt so groß wie das 7b-Modell, aber nur 0,04 besser und läuft mit 23 statt 44 Tokens pro Sekunde. Das neuere qwen3 mit 4 Milliarden schlägt beide. Selbst das größte lokale Modell im Test, qwen3:30b-a3b, kommt nur auf 0,75. Bei den Keywords ist es mit 0,96 das beste lokale Modell, bei Snippets und technischem SEO aber schwächer als qwen3:4b-instruct. Trotz Auslagerung lief es mit 41 Tokens pro Sekunde zügig, weil je Token nur ein Zehntel der Parameter rechnet.[1] Drittens ist der Unterschied innerhalb der Cloud klein. Haiku liegt mit 0,98 fast gleichauf mit Opus. Für Aufgaben dieser Art brauchst du nicht das größte Modell.
Beim Tempo sind die lokalen Modelle ohne Denkmodus übrigens nicht langsamer als die Cloud. Mit 2,3 bis 3,9 Sekunden je Aufgabe liegen sie im selben Bereich wie Claude. Der Ausreißer ist DeepSeek Flash mit 0,6 Sekunden. Codex ist am langsamsten, weil die Kommandozeile als Agent bei jedem Aufruf rund 11.500 Tokens an Anweisungen mitschickt, bei Claude sind es etwa 1.000.[1]
Kostenlose SEO Tools
Keyword-Ranking, SSR-Text-Check, Sitemap-Audit und mehr, direkt im Browser und ohne Anmeldung.
Zufriedene Kunden und Case Studies: Alle Case Studies
Wo lokale KI-Modelle scheitern
Der Mittelwert verdeckt, dass die Fehler nicht zufällig verteilt sind. Bei Alt-Texten und FAQ-Extraktion liefern alle lokalen Modelle volle Punkte. An anderen Stellen scheitern fast alle.[1]
Rechnen ohne Zwischenschritte
Die schwerste Aufgabe für lokale Modelle war eine einfache Potenzialrechnung: Eine Seite rankt auf Position 8 mit 40.000 Impressionen, die CTR liegt auf Position 8 bei 0,61 Prozent und auf Position 3 bei 2,37 Prozent. Wie viele Klicks bringt der Sprung auf Position 3? Richtig sind 40.000 mal 1,76 Prozent, also 704 Klicks.[7] qwen3:4b-instruct antwortete 190, qwen2.5:7b 152. Kein lokales Modell ohne Denkmodus kam auf 704, alle acht Cloud-Modelle schon. Im Schnitt erreichten die lokalen Läufe hier 0,20 Punkte.[1]
Für die Praxis heißt das: Lass ein lokales Modell nie selbst rechnen. Gib ihm die Rechnung als Code oder lass es eine Formel ausgeben, die ein Skript ausführt.
Längenvorgaben und Content-Gaps
Zeichengrenzen sind für kleine Modelle schwer, weil sie in Tokens denken, nicht in Buchstaben. Bei drei Title-Varianten mit höchstens 60 Zeichen lieferte qwen3:4b-instruct zweimal 62 Zeichen, das 14b-Modell einmal 63. Bei der Meta Description mit 140 bis 160 Zeichen kam qwen2.5:7b auf 70 Zeichen.[1] Das sind kleine Abweichungen, aber im Snippet werden genau diese Zeichen abgeschnitten.
Noch deutlicher war der Content-Gap: Eigene H2 und Wettbewerber-H2 einer Wärmepumpen-Seite vergleichen und die fehlenden Themen nennen. Richtig sind Lautstärke, Stromtarif und Wartung. Die lokalen Modelle nannten stattdessen Themen, die schon auf der eigenen Seite stehen, etwa Installationskosten. Lokal lag der Schnitt bei 0,21, in der Cloud bei 0,92.[1] Das ist der Teil, für den du ein Modell bei einer Content-Gap-Analyse eigentlich brauchst.
Technisches SEO mit Fallstricken
Bei der Frage, welche hreflang-Werte ungültig sind, und bei der Weiterleitungskette mit einer 302 in der Mitte lagen die lokalen Modelle um 0,4. Die hreflang-Aufgabe war auch für die Cloud die zweitschwerste: Dass Google en-UK ignoriert und es-419 nicht unterstützt, wussten nur zwei Cloud-Modelle vollständig.[1][2] Bei robots.txt, Sitemap und JSON-LD lagen die lokalen Modelle dagegen meist richtig.
Denkmodus: genauer, aber bis zu 15-mal langsamer
qwen3 kann vor der Antwort „nachdenken“, also Zwischenschritte schreiben, die Ollama über den Parameter think steuert.[5] Damit löst qwen3:8b die Klickrechnung korrekt mit 704 und kommt auf 20 voll richtige Aufgaben statt 15. Die Genauigkeit bleibt trotzdem bei 0,76, weil das Modell an anderen Stellen schlechter wird, etwa beim Clustern von Keywords.[1]
Der Preis ist die Zeit. qwen3:8b brauchte im Median 14,8 statt 3,3 Sekunden je Aufgabe. qwen3:4b brauchte 41,9 Sekunden und für alle 29 Aufgaben 1.300 Sekunden, das 15-Fache der Variante ohne Denkmodus. In acht Aufgaben drehte sich das kleine Modell im Kreis, bis die Obergrenze von 4.096 Tokens erreicht war.[1]
qwen3:4b ist bei Ollama inzwischen die reine Denk-Variante (Version 2507). Den Denkmodus abzuschalten hilft dort nicht, das Modell denkt trotzdem. Ohne Denkmodus brauchst du qwen3:4b-instruct.[4][1] Ich habe eine halbe Stunde gebraucht, um das zu finden, weil der erste Lauf nur aus Abbrüchen bestand.Was ich an meiner eigenen Bewertung korrigieren musste
Bevor ich die Zahlen für belastbar hielt, habe ich mir jede falsche Antwort einzeln angesehen. Mehrmals lag der Fehler bei meiner Prüfung:
- hreflang: Meine erste Musterlösung hielt
es-419für gültig. Google schreibt ausdrücklich, dass solche Codes nicht unterstützt werden.[2] Die beiden Codex-Modelle, die das bemängelten, hatten recht. - 404 oder 410: Bei der dauerhaft entfernten Produktseite ist 410 die übliche Empfehlung. Google selbst behandelt alle 4xx-Codes außer 429 gleich.[3] Eine Antwort mit 404 bekommt deshalb halbe Punkte statt null.
- Formatfragen: „E-Bike-Leasing“ mit Bindestrich, Entitäten als Objekte statt als Text, eine Regex mit angehängter Erklärung. Inhaltlich richtig, von meiner ersten Prüfung trotzdem abgelehnt.
- Verpackte Listen: qwen2.5:14b packte 13-mal eine verlangte Liste in ein Objekt. Das zähle ich jetzt getrennt, statt die ganze Antwort zu verwerfen.[1]
Die Lehre daraus deckt sich mit dem, was ich im Oktober 2026 im Kickoff mit einem Industriekunden besprochen habe: Ein Sprachmodell erreicht nie 100 Prozent. Was zählt, ist ein Validator im Skript, der Fehler erkennt und ans Modell zurückgibt, bis die Ausgabe stimmt.[6] Das gilt für die Prüfung genauso. Wer einen Modellvergleich nur nach dem Mittelwert liest, ohne die Fehler je Aufgabe anzusehen, misst am Ende seine eigenen Sollwerte.
Wofür sich lokale KI-Modelle im SEO lohnen
Lokale Modelle sind nach diesem Test kein Ersatz für Claude oder Codex, wenn es um Analyse geht. Sie sind aber auch nicht nutzlos. Gut genug waren qwen3:4b-instruct und qwen2.5:7b bei diesen Aufgaben:
- Suchintent und Brand-Keywords klassifizieren (0,85 bis 0,90 in der Kategorie Keywords)
- Alt-Texte, FAQ-Extraktion und H2-Gliederungen (über 0,9 in der Kategorie Texte)
- robots.txt, Sitemap-Regeln und JSON-LD erzeugen, wenn ein Validator nachprüft
Das sind genau die Massenaufgaben, bei denen Daten oft das Haus nicht verlassen dürfen: Tausende Keywords aus der Search Console, interne Produktdaten, Texte vor der Veröffentlichung.[1] Rechnen, Content-Gaps und knifflige Technikfragen gehören dagegen in ein großes Modell oder in klassischen Code. Wie du Claude datenschutzkonform einsetzt, wenn es doch die Cloud sein soll, habe ich im Artikel zu Claude, Datenschutz und DSGVO beschrieben. Ob du für deine Daten eher RAG, Fine-Tuning oder einen guten Prompt brauchst, steht im Beitrag RAG, Fine-Tuning oder Prompt.
Bei den Kosten lohnt ein ehrlicher Blick. Ein lokales Modell kostet keine Gebühr je Anfrage, aber Hardware, Strom und Pflege. Die Cloud-Modelle liefen in meinem Test über bestehende Abos, ohne Zusatzkosten je Aufruf; was die Abos im Alltag kosten, steht im Artikel zu den Kosten von Claude Code. Wenn es um reine Menge geht, ist DeepSeek Flash interessant: 0,93 Genauigkeit und alle 29 Aufgaben in 18 Sekunden.[1] Für Daten, die nicht nach außen dürfen, ist es natürlich keine Lösung.
Fazit
Lokale KI-Modelle schaffen bei SEO-Aufgaben rund drei Viertel dessen, was Cloud-Modelle leisten. Das beste lokale Modell im Test, qwen3:4b-instruct, kam auf 0,77, das kleinste Claude-Modell auf 0,98. Lokal reicht es für Klassifizieren, Extrahieren und einfache Technik, wenn ein Skript die Ausgabe prüft. Beim Rechnen, bei Content-Gaps und bei Fallstricken wie hreflang scheitern die kleinen Modelle, und der Denkmodus behebt das nur teilweise, zum Preis von bis zu 15-facher Laufzeit.[1]
Mein Rat nach diesem Test: Entscheide pro Aufgabe, nicht pro Modell. Was sensible Daten berührt und sich prüfen lässt, kann lokal laufen. Was Urteilsvermögen braucht, gehört in ein großes Modell. Und bevor du einem Modellvergleich glaubst, auch meinem, schau dir an, woran die Modelle gescheitert sind.
Quellen
- Eigener Test: 29 SEO-Aufgaben mit automatischer Prüfung, 18 Modellläufe (Qwen über Ollama auf Nvidia Tesla T4, Claude und Codex über Abo-Kommandozeile, DeepSeek über API), 522 Antworten. Durchgeführt am 21. und 22.11.2026. Aufgaben, Skript und alle Antworten: github.com/AntonioBlago/seo-llm-bench.
- Google Search Central: Tell Google about localized versions of your page (hreflang, unterstützte Sprach- und Regionscodes). developers.google.com, abgerufen am 21.11.2026.
- Google Crawling Infrastructure: How HTTP status codes affect Google's crawlers. developers.google.com, abgerufen am 21.11.2026.
- Ollama Library: qwen3, verfügbare Varianten. ollama.com, abgerufen am 21.11.2026.
- Ollama API-Dokumentation, Parameter
thinkundoptions. github.com/ollama, abgerufen am 21.11.2026. - Eigene Gespräche mit Kunden und Interessenten, Juni bis Oktober 2026, Transkripte lokal, anonymisiert.
- Antonio Blago: Keyword-Studie 2026, CTR nach Position in der organischen Suche. antonioblago.com.
Kostenloses Erstgespräch
30 Minuten, deine Website, konkrete nächste Schritte. Ohne Verkaufsdruck.
Zufriedene Kunden und Case Studies: PURELEIShopify-RelaunchAlle Case Studies
Über den Autor: Antonio Blago
SEO Freelancer & AI Visibility Experte
Ich optimiere SEO datengetrieben mit Python, Verkaufspsychologie und meinem Neuro-SEO System®. Auf YouTube, LinkedIn und Instagram teile ich regelmäßig praxisnahe Anleitungen, Insights und aktuelle SEO-Tricks.