Claude datenschutzkonform nutzen: DSGVO-Leitfaden 2026

KI-Zusammenfassung
- Im Team-Plan von Claude gibt es automatisch einen Auftragsverarbeitungsvertrag mit Standardvertragsklauseln, kein Training mit Inhalten und 30 Tage Speicherung.
- Claude ist datenschutzkonform nur durch das Zusammenspiel aus Vertrag, Einstellungen und der Wahl, welche Daten man hineingibt, nicht durch das Tool allein.
- Feedback-Befehle in Claude Code speichern komplette Unterhaltungen fünf Jahre bei Anthropic, weshalb DISABLE_FEEDBACK_COMMAND und DISABLE_TELEMETRY auf 1 gesetzt werden sollten.
- Ein Python-Skript anonymisierte 302 Transkripte und ersetzte dabei 9.121 Namen, 1.114 E-Mail-Adressen und weitere personenbezogene Daten, bevor Daten zu Claude gehen.
Automatisch mit KI erstellt, die Details stehen im Artikel.
Inhaltsverzeichnis
Serie Claude Code, alle Teile:
Leitfaden-Serie
- Claude Code: Was es ist und wie du es nutzt (Leitfaden)
- Claude Code installieren und einrichten: die Anleitung
- Claude Code Kosten 2026: Preis, Abo, Limits und API
- Claude Code Skills: die besten für Entwickler
- Codex vs. Claude Code: Gemini CLI, Copilot und Cursor im Vergleich
- Claude datenschutzkonform nutzen: DSGVO-Leitfaden (dieser Beitrag)
- Claude im Team nutzen: Team-Plan, Enterprise und Setup
Aus der Praxis
- Agentic SEO Systeme 2026: Claude Code als SEO-Schaltzentrale
- Agentic Engineering: 100+ SEO-Projekte allein mit KI
- Claude Skills in der Praxis: Peec AI MCP Challenge
- Onlineshop mit Claude Code bauen: Happy Coffee
Studien
- KI-Halluzinationen: Was DELEGATE-52 für Unternehmen zeigt
- Wie LLMs Marken ranken: eine statistische Studie
Be Ahead Newsletter
Ich habe mir den Team-Plan von Claude gebucht und an einem Sonntag meinen kompletten Arbeitsplatz durchgesehen: Admin-Konsole, Claude-Code-Einstellungen, AVV, Dokumentation, und am Ende ein Skript, das meine Gesprächstranskripte anonymisiert, bevor Claude sie überhaupt sieht[19]. Dabei habe ich Dinge gefunden, die ich so nicht erwartet hätte, zum Beispiel einen API-Key im Klartext in meinen eigenen Einstellungen. Dieser Artikel ist die Anleitung, die ich mir vorher gewünscht hätte.
Die Frage, ob man Claude datenschutzkonform nutzen kann, höre ich ständig. Ein Industriekunde darf das Programmierwerkzeug von Anthropic erst einsetzen, wenn die Konzern-IT das Tool freigegeben hat[18]. Meine kurze Antwort: DSGVO-konform ist keine Eigenschaft eines Tools. Es ist das Zusammenspiel aus Vertrag, Einstellungen und der Frage, welche Daten du überhaupt hineingibst. Wie der Agent im Terminal grundsätzlich funktioniert, steht im Claude Code Leitfaden.
Methodik und eigene Untersuchung: Jede Aussage zu Anthropic habe ich am 01.11.2026 gegen die offiziellen Seiten von Anthropic geprüft und unten verlinkt. Die Einstellungen habe ich in meinem eigenen Team-Konto gesetzt und getestet, die Zahlen zur Anonymisierung stammen aus meinem Lauf über 302 Transkripte.
Die ehrliche Antwort: Wie datenschutzkonform kann Claude sein?
Absolut sicher ist nur ein Sprachmodell, das auf deiner eigenen Hardware läuft und dessen Daten deinen Server nie verlassen. Das geht, kostet aber Geld, Zeit und Qualität. Für die meisten Selbstständigen, Agenturen und Mittelständler ist das die falsche Rechnung.
Realistisch betrachtet: Die meisten von uns arbeiten ohnehin mit Google Workspace, Microsoft 365, Notion, Zoom und Social Media. Alle diese Dienste verarbeiten Daten in den USA, und wir sichern sie über Auftragsverarbeitungsverträge, Standardvertragsklauseln und vernünftige Einstellungen ab. Für Claude gilt dieselbe Logik. Wer diese Grundausstattung sauber umsetzt und Claude for Enterprise nur bei echtem Bedarf hinzunimmt, ist für normale Geschäftsdaten gut aufgestellt.
Anders sieht es aus, wenn besondere Kategorien nach Art. 9 DSGVO im Spiel sind: Gesundheitsdaten, Mandantenakten, Bewerberdaten. Genau diese Unterscheidung kam in einem Gespräch im Oktober auf: Viele Firmen verbieten Claude per KI-Richtlinie pauschal, obwohl Marketingdaten oder Search-Console-Daten keine hochsensiblen Daten sind. In der Kundenkommunikation im regulierten Umfeld braucht es dagegen ein anderes Setup[18]. Eine Marketing-Leiterin aus der Industrie hat es im Juni noch knapper formuliert, als wir über lokale Modelle als Alternative sprachen: Irgendein Spezialist muss das am Ende zertifizieren[18].
Kosten-Nutzen: vier Stufen im Vergleich
Ich denke Datenschutz bei KI in Stufen. Jede Stufe kostet mehr und schützt mehr. Die Frage ist, welche Stufe zu deinen Informationen passt.
| Stufe | Was du bekommst | Kosten | Für wen |
|---|---|---|---|
| 1: Pro oder Max mit Opt-out | Training aus, 30 Tage Speicherung, aber kein AVV | 17 bis 200 USD im Monat | Privat, eigene Inhalte ohne Kundendaten |
| 2: Team-Plan, Einstellungen, Anonymisierung | AVV mit Standardvertragsklauseln, kein Training, 30 Tage, Admin-Kontrolle | 20 bis 125 USD je Platz und Monat | Freelancer, Agenturen, KMU |
| 3: Enterprise oder Claude über AWS/Google in der EU | Verarbeitung in EU-Regionen, Zero Data Retention nur für qualifizierte Enterprise-Kunden | Sitzpreis plus Nutzung zu API-Preisen, regional 10 % Aufschlag | Konzerne, regulierte Branchen |
| 4: Eigenes Modell, selbst gehostet | Daten verlassen deinen Server nicht | GPU-Server ab 214 € im Monat plus Betrieb | Gesundheit, Recht, hohe Sensibilität |
Stufe 3: Claude über AWS Bedrock oder Google Vertex
Anthropic selbst bietet für seine eigene API derzeit keine Verarbeitung in der EU an. Für den Ort der Berechnung heißen die Optionen „us“ und „global“, und der Speicherort ist laut Dokumentation aktuell nur „us“[9]. Wer Claude in einer EU-Region verwenden und verarbeiten lassen will, geht über AWS Bedrock oder Google Vertex AI. Bei Bedrock gibt es EU-Inferenzprofile, Frankfurt ist dabei[6]. Der Agent lässt sich darauf umstellen, mit CLAUDE_CODE_USE_BEDROCK=1 und einer EU-Region, bei Google mit CLAUDE_CODE_USE_VERTEX=1[7][8].
Im Netz liest man oft, AWS verlange für Claude den doppelten Preis. Das konnte ich nicht bestätigen. Laut Anthropic kosten regionale Endpunkte bei Bedrock und Google 10 Prozent mehr als die globalen, der globale Endpunkt hat keinen Aufschlag[5][6]. Der eigentliche Aufwand liegt woanders: AWS- oder Google-Konto, Rechte, Abrechnung nach Verbrauch statt Flatrate. Für ein kleines Team ist das selten die bessere Wahl. Zero Data Retention, also gar keine Speicherung bei Anthropic, gibt es für Claude Code nur für qualifizierte Enterprise-Kunden, nicht im Team-Plan[17].
Stufe 4: Self-Hosting mit offenen Modellen
Offene Coding-Modelle wie Devstral Small (24 Milliarden Parameter, läuft laut Hersteller auf einer RTX 4090 oder einem Mac mit 32 GB) oder Qwen3-Coder lassen sich lokal über Ollama oder LM Studio betreiben[12][13]. Wer solche Modelle für ein Team verwenden will, braucht einen Server und zahlt bei Hetzner 214 € im Monat für eine GPU mit 24 GB und bei 999 € für 96 GB, jeweils netto plus Einrichtungsgebühr[10]. Dazu kommen Wartung, Updates und die Tatsache, dass diese Modelle bei langen, mehrstufigen Aufgaben spürbar schwächer sind als Claude. Für die meisten ist Stufe 4 ein Projekt für sich, kein Werkzeug.
Ein Mittelweg ist ein europäischer Anbieter wie Mistral. Dort gibt es einen Team-Tarif und für Enterprise auch Self-Hosting oder On-Premise[11]. Mit dem Agenten von Anthropic funktioniert das aber nicht direkt.
Meine Empfehlung: Stufe 2. Sie kostet wenig, deckt den Vertrag ab und lässt sich in einem Nachmittag umsetzen. Der Rest dieses Artikels beschreibt genau diese Stufe.
KI-Automation für SEO Workshop: Prompts, Agenten und APIs
Zwei Tage, in denen dein Team eigene KI-Agenten für SEO- und Content-Aufgaben baut: Prompt-Engineering, Custom GPTs und Copilot-Agenten, Keyword-Clustering, Content-Pipelines und Automatisierung über APIs. Jeder baut am Ende einen eigenen Agenten.
Training mit deinen Daten: Consumer-Tarife und Team-Plan beim Anbieter
Der wichtigste Schritt ist die Wahl des Tarifs. Free, Pro, Max und Ultra laufen unter den Consumer-Bedingungen. Seit dem 28.08.2025 entscheidest du dort selbst, ob deine Chats und Claude-Code-Sitzungen zum Training genutzt werden[2]. Lässt du das Training an, speichert Anthropic die Daten fünf Jahre, schaltest du es aus, 30 Tage[3]. Was bereits trainiert wurde, bleibt trainiert.
Das Problem: Für Consumer-Tarife gibt es keinen Auftragsverarbeitungsvertrag. Sobald du Kundendaten verarbeitest, brauchst du aber einen. Eine Personal Trainerin hat mich im Oktober genau danach gefragt, als ich ihr Vibe Coding für ihre Website empfohlen habe. Meine Antwort war: Training abschalten reicht für die eigene Website, für Kundendaten braucht es den Vertrag[18].
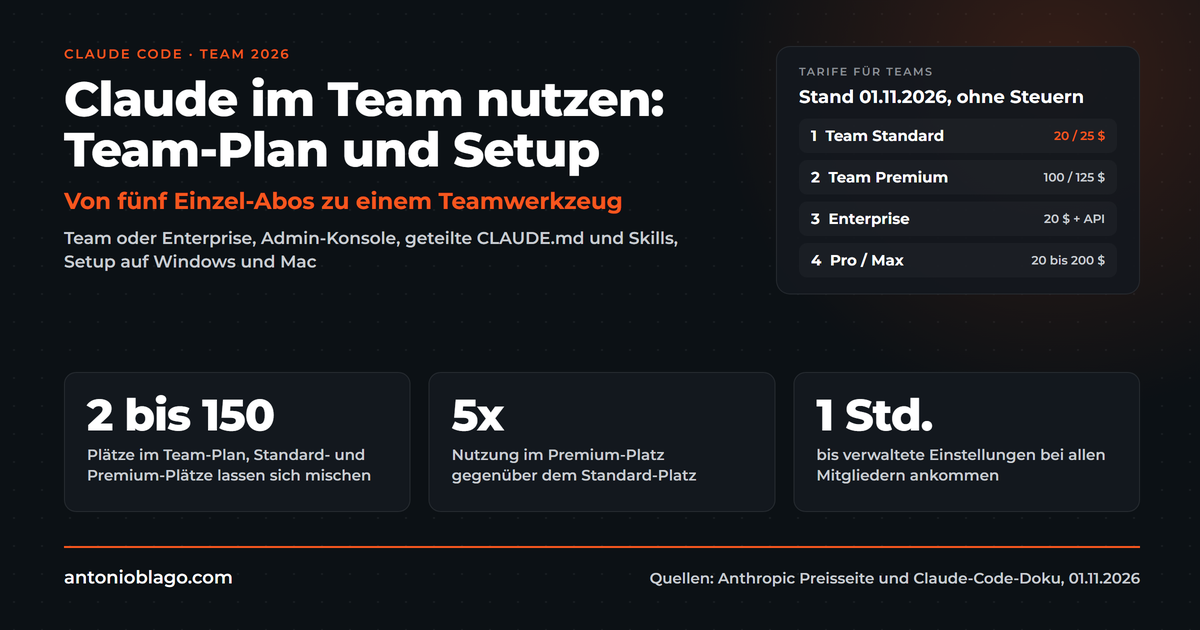
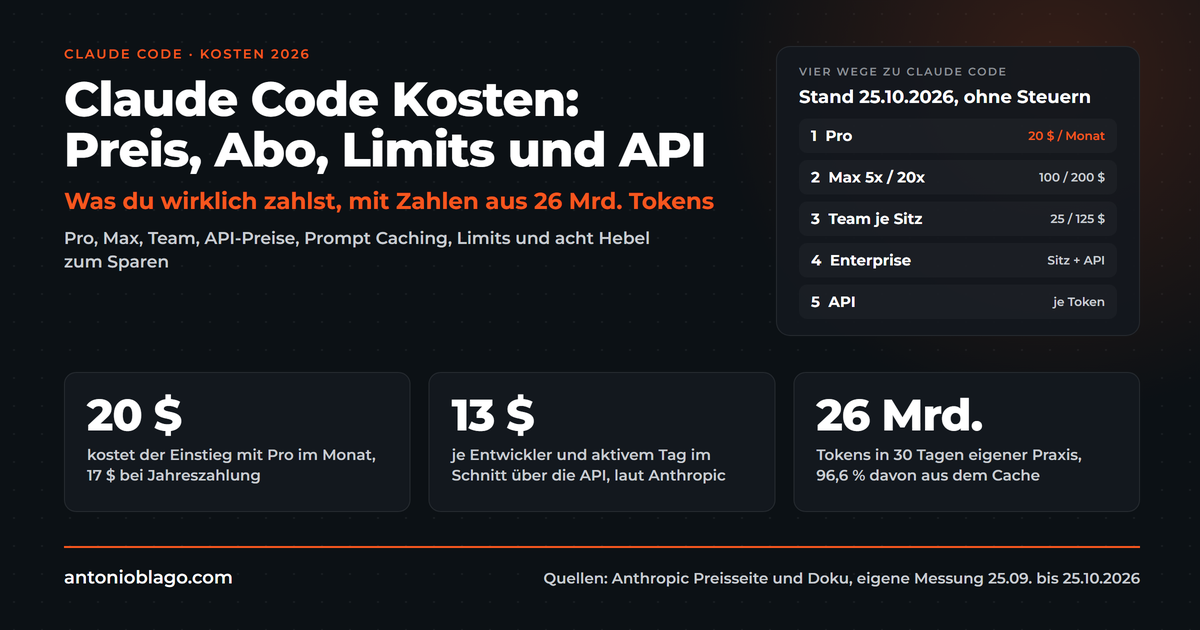
Der Team-Plan (offiziell „Claude for Teams“, darüber liegt „Claude for Enterprise“) läuft unter den Commercial Terms. Die Datenschutzrichtlinie und die Nutzungsbedingungen für Unternehmen gelten damit anders als im Consumer-Tarif. Das heißt: kein Training mit deinen Inhalte, 30 Tage Speicherung und ein Data Processing Addendum mit Standardvertragsklauseln, das automatisch Teil des Vertrags ist[3][15]. Eine Unterschrift ist nicht nötig. Claude for Teams ist ab zwei Plätzen buchbar und kostet 20 USD je Standard-Platz bei Jahreszahlung oder 25 USD monatlich[1]. Was das alles insgesamt kostet, habe ich im Artikel zu den Claude Code Kosten nachgerechnet.
Wichtig: Der Schutz gilt nur, wenn alle mit dem Team-Konto angemeldet sind. Wer auf dem Firmenrechner mit seinem privaten Pro-Konto in Claude Code arbeitet, arbeitet unter Consumer-Bedingungen.
Schritt für Schritt: Admin-Konsole im Team-Plan
Nach der Buchung lohnt sich ein Gang durch die Admin-Einstellungen. Bei mir war das meiste schon sinnvoll voreingestellt, zwei Schalter habe ich trotzdem geändert[19].
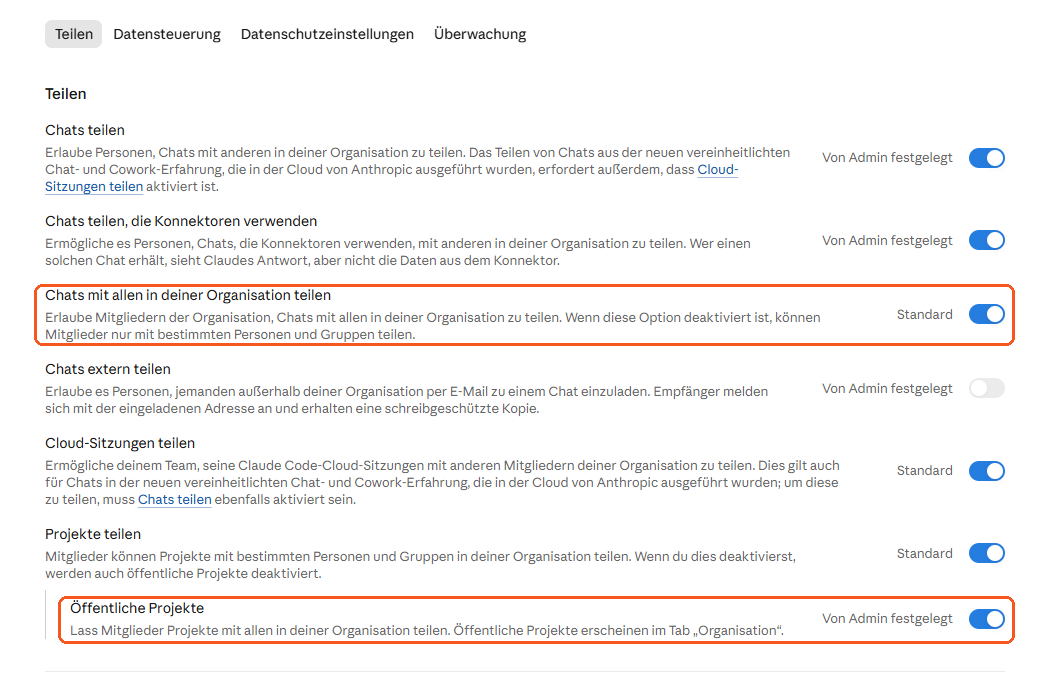
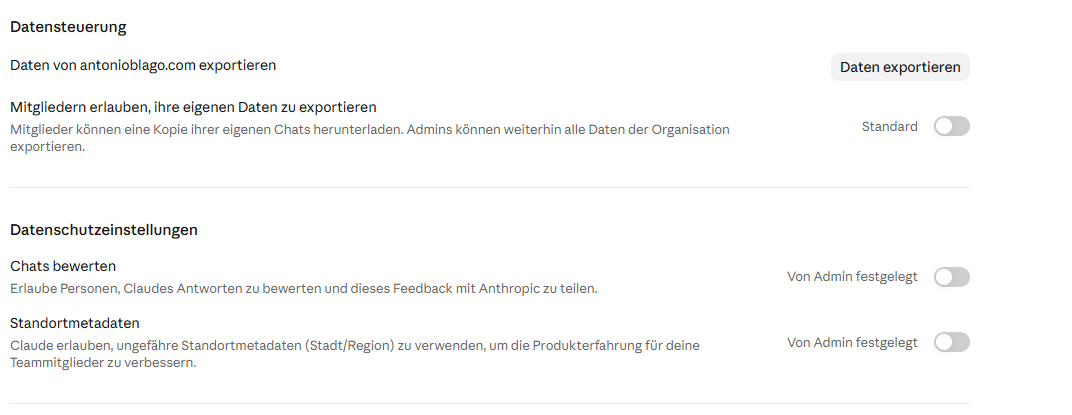
Teilen, Feedback und Standort
- Chats bewerten: aus. Sonst können Nutzer Bewertungen samt Gesprächsinhalt an Anthropic schicken.
- Standortmetadaten: aus.
- Chats extern teilen: aus.
- Chats mit allen in der Organisation teilen: aus. Dann teilen Mitglieder nur mit bestimmten Personen, also mit denen, die am jeweiligen Kunden arbeiten.
- Öffentliche Projekte: aus. Sonst sieht jedes Mitglied alle Kundenprojekte im Tab „Organisation“.
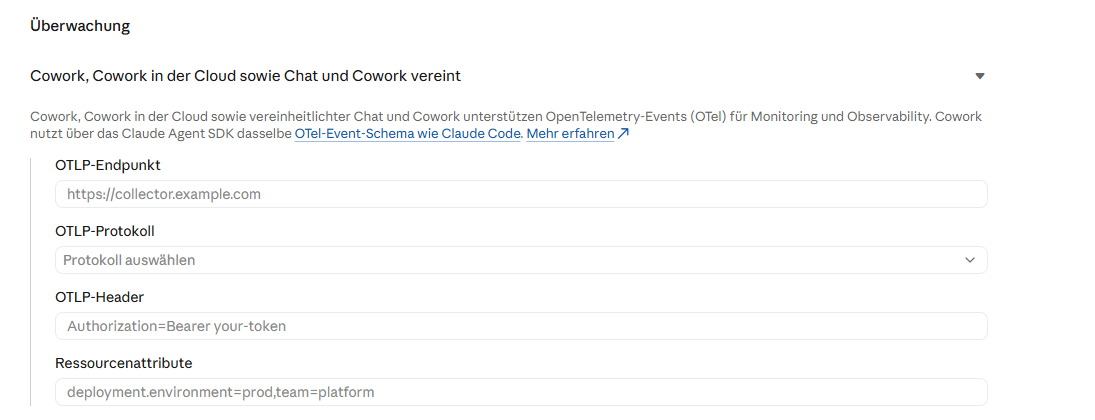
- Überwachung (OpenTelemetry): leer lassen. Dort tragen Firmen einen eigenen Server ein, um die Nutzung auszuwerten. Ohne Eintrag wird nichts gesendet. Mit Eintrag wäre der Empfänger ein weiterer Auftragsverarbeiter.
Verwaltete Einstellungen für Claude Code
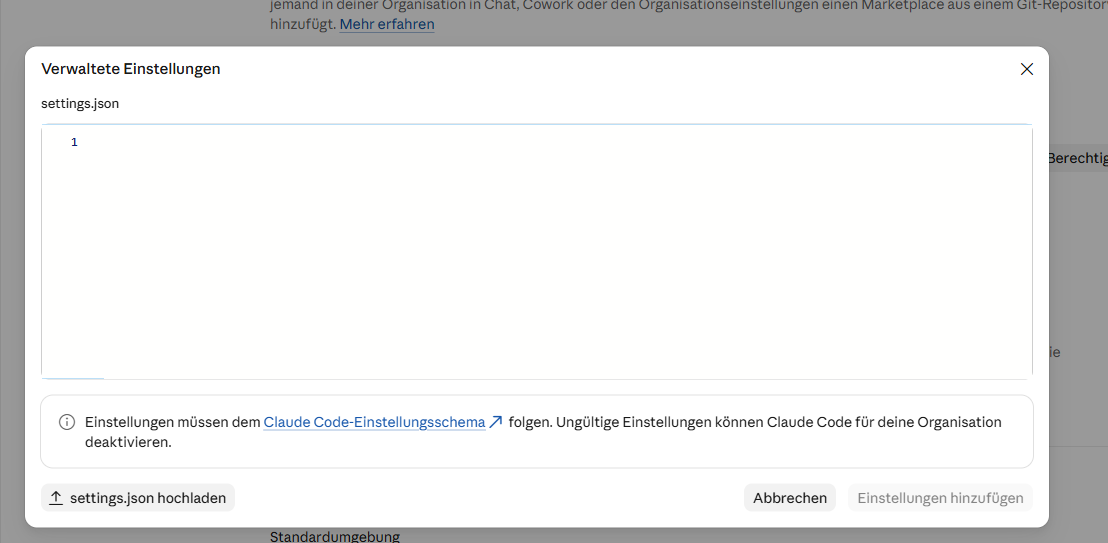
Im Team-Plan kannst du unter Organisationseinstellungen › Claude Code › Verwaltete Einstellungen eine settings.json hinterlegen, die für alle Mitglieder gilt und lokal nicht überschrieben werden kann[16]. Meine sieht so aus:
{
  "permissions": {
    "disableBypassPermissionsMode": "disable",
    "deny": [
      "Read(**/.env)",
      "Read(**/.env.*)",
      "Read(**/*token*.json)",
      "Read(**/credentials*)"
    ]
  },
  "env": {
    "DISABLE_TELEMETRY": "1",
    "DISABLE_FEEDBACK_COMMAND": "1",
    "CLAUDE_CODE_DISABLE_FEEDBACK_SURVEY": "1"
  }
}
Das sperrt den Modus, in dem Claude Code ohne Rückfrage alles darf, verbietet das Lesen typischer Geheimnis-Dateien und schaltet Feedback und Telemetrie ab. Vorsicht: Laut Admin-Oberfläche kann eine ungültige Datei Claude Code für die ganze Organisation abschalten. Prüfe vorher, ob deine Automatisierungen den Bypass-Modus nutzen, und teste danach in einer neuen Sitzung.
Claude Code absichern: Einstellungen, die wirklich greifen
Claude Code liest Dateien, führt Befehle aus und schickt den Kontext an Anthropic. Deshalb lohnt sich hier ein genauerer Blick als bei der Web-Oberfläche.
Feedback und Telemetrie abschalten
Der unterschätzte Punkt: Wer in Claude Code /bug, /feedback oder /share nutzt, schickt die komplette Unterhaltung an Anthropic, und diese Transkripte werden fünf Jahre gespeichert, auch im Team-Plan[3]. Ein versehentlicher Fehlerbericht mitten in einer Kundensitzung reicht. Ich habe deshalb drei Schalter in die env meiner ~/.claude/settings.json gesetzt: DISABLE_FEEDBACK_COMMAND, CLAUDE_CODE_DISABLE_FEEDBACK_SURVEY und DISABLE_TELEMETRY, jeweils auf "1". Den Sammelschalter CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC habe ich bewusst nicht gesetzt, weil er auch Funktionen wie Remote Control abschalten kann[3].
Lesesperren statt .claudeignore
In vielen Anleitungen steht, man solle eine .claudeignore anlegen. Die Dokumentation sagt dazu wörtlich, eine solche Datei habe keine Wirkung, ihre Einträge gehören in Lesesperren[4]. Lesesperren schreibst du unter permissions.deny, zum Beispiel Read(./.env) oder Read(./Buchhaltung/**), die Muster folgen der Syntax von .gitignore[4].
Eine Einschränkung muss man kennen: Diese Sperren gelten für Claudes eigenes Lese-Werkzeug. Ein Shell-Befehl wie cat kann dieselbe Datei trotzdem lesen. Wer das wasserdicht will, kombiniert die Sperren mit der Sandbox oder einem Hook, der solche Befehle blockiert[4]. Ich nutze für Mails bereits einen Hook, der jeden Versand ohne Freigabe stoppt, nach demselben Muster lässt sich der Zugriff auf sensible Ordner sperren.
Keine Geheimnisse in Einstellungen
Mein peinlichster Fund: In meiner settings.json stand ein API-Key im Klartext. Er war vor Monaten in eine Erlaubnisregel gerutscht, als ich einen export-Befehl mit dem Key freigegeben hatte[19]. Der Agent speichert freigegebene Befehle wörtlich. Schau deshalb einmal durch deine permissions.allow, ob dort Keys, Tokens oder Passwörter stehen. Zugangsdaten gehören in eine .env, die per Lesesperre geschützt ist, nicht in Befehle und nicht in den Chat.
Lokale Protokolle
Claude Code speichert jede Sitzung lokal im Klartext unter ~/.claude/projects/, standardmäßig 30 Tage lang[3]. Mit cleanupPeriodDays kannst du das verkürzen. Ich habe es bei 30 Tagen gelassen, weil ich alte Sitzungen für Übergaben und Zeiterfassung nutze. Wichtiger ist, dass der Rechner verschlüsselt ist, unter Windows mit BitLocker.
Datensicherheit und Prompt Injection
Datensicherheit heißt bei einem Agenten auch: Er liest Inhalte, denen du nicht vertraust. Eine Webseite, eine Mail oder eine fremde Datei kann Anweisungen enthalten, die der Agent als Auftrag versteht. Dieser Angriff heißt Prompt Injection. Gegen ihn hilft vor allem ein enger Rechterahmen: Lesesperren für Geheimnisse, Rückfrage vor Schreibzugriffen und Netzwerkzugriff nur dort, wo er gebraucht wird. Je weniger personenbezogene Daten im Kontext liegen, desto kleiner ist der Schaden, wenn doch etwas durchrutscht.
Anonymisieren, bevor Daten zu Claude gehen
Datenschutz beginnt bei der Menge. Was Claude nicht sieht, muss niemand schützen. Ich nutze für Blogartikel und Präsentationen eigene Erfahrungen aus Kundengesprächen, und die liegen als Transkripte mit vollen Namen, E-Mail-Adressen und Zahlen auf meinem Rechner. Als ich im Oktober Subagenten Transkripte wörtlich ablegen ließ, hat der Sicherheitsfilter von Claude mehrere Schreibvorgänge mit personenbezogenen Inhalten gestoppt[18]. Das war der Anstoß, das Problem vorher zu lösen.
Als Praxisbeispiel und Fallstudie meines eigenen Arbeitsplatzes habe ich deshalb ein kleines Python-Skript geschrieben, das lokal läuft, ganz ohne KI-Aufruf. Es behält Vornamen, damit die Texte lesbar bleiben, und ersetzt den Rest:
- Nachnamen fallen weg, aus „Nachname, Vorname“ wird „Vorname“.
- Kunden werden zu Branchen-Platzhaltern wie „[Dämmstoffhersteller]“ oder „[Beauty-Shop]“, auch ihre Domains und falsch verhörte Schreibweisen.
- E-Mail-Adressen, Telefonnummern, IBANs, Links, Meeting-IDs und Geldbeträge werden zu „[E-Mail]“, „[Betrag]“ und so weiter.
Beim ersten Lauf über 302 Transkripte hat es 9.121 Namen, 1.114 E-Mail-Adressen und 1.158 Beträge ersetzt[19]. Die Transkriptsuche, die meine Skills nutzen, gibt seitdem nur noch die anonyme Fassung zurück. Claude bekommt die Originale also gar nicht mehr zu sehen.
Die Grenzen sage ich offen: Das ist Pseudonymisierung, keine Anonymisierung im Sinne der DSGVO. Vorname, Rolle und Branche zusammen können eine Person noch erkennbar machen. Und Dritte, die im Gespräch nur erwähnt werden und nie selbst sprechen, erkennt ein regelbasiertes Skript nicht. Wer mehr will, setzt eine lokale Namenserkennung wie Microsoft Presidio ein. Für meinen Zweck reicht die einfache Variante plus ein kurzer Blick vor jeder Veröffentlichung.
Dokumentation zur Verarbeitung personenbezogener Daten: Diese Nachweise brauchst du
Einstellungen schützen, Dokumentation beweist. Wenn ein Kunde oder eine Aufsichtsbehörde fragt, zählt, was du vorlegen kannst. Ich habe dafür einen Ordner „Datenschutz“ mit diesen Dateien angelegt[19]:
| Nachweis | Inhalt | Grundlage |
|---|---|---|
| AVV / DPA | DPA von Anthropic als PDF mit Datum, dazu die Liste der Unterauftragsverarbeiter | Art. 28 DSGVO |
| Liste der Dienste | Jeder Dienst, der Kundendaten sieht, mit AVV-Status, auch jeder angebundene MCP-Server | Art. 28 DSGVO |
| Verarbeitungsverzeichnis | Eintrag „KI-gestützte Analyse und Texterstellung“ mit Zweck, Daten, Empfängern, Fristen | Art. 30 DSGVO |
| TOMs | Die Einstellungen aus diesem Artikel, je Punkt mit Status | Art. 32 DSGVO |
| Transferprüfung USA | Standardvertragsklauseln, 30 Tage, kein Training, Pseudonymisierung | Art. 44 ff. DSGVO |
| Schwellwertprüfung DSFA | Begründung, ob eine Folgenabschätzung nötig ist | Art. 35 DSGVO |
| KI-Kompetenz | Wer ist wie geschult | Art. 4 KI-Verordnung |
Drei Punkte, die oft vergessen werden:
- Zweckbindung: Daten, die ein Kunde dir für ein Projekt gibt, nutzt du nur für dieses Projekt. Ein Skill, der Kundendaten für ein anderes Projekt weiterverwendet, verletzt die Zweckbindung.
- Kunden-AVVs: Wer für Kunden arbeitet, ist selbst Auftragsverarbeiter. Anthropic muss dann als Unterauftragsverarbeiter in deinen AVV mit dem Kunden, und der Kunde muss zustimmen. Danach fragen Kunden zuerst.
- Datenschutz-Folgenabschätzung: Sie ist nicht automatisch Pflicht, nur weil KI im Spiel ist. Prüfe die Kriterien. Bei mir trifft nur „neue Technologie“ zu, weil ich keine besonderen Kategorien verarbeite. Neu bewerten, sobald Gesundheits- oder Bewerberdaten über KI laufen.
- Haftung: Gegenüber deinem Kunden haftest du für die Verarbeitung, auch wenn ein Unterauftragsverarbeiter Fehler macht. Prüfe deshalb die Haftungsklauseln in deinen eigenen Verträgen.
- KI-Kompetenz: Seit dem 02.02.2025 müssen Unternehmen, die KI einsetzen, für ausreichende KI-Kompetenz ihrer Leute sorgen, und seit dem 02.08.2026 prüfen das die nationalen Behörden[14]. Eine kurze Notiz, wer wann eingewiesen wurde, reicht als Anfang.
Beim Drittlandtransfer in die USA gilt: Ob Anthropic unter dem EU-US Data Privacy Framework zertifiziert ist, konnte ich nicht automatisch prüfen. Schau selbst in die Liste auf dataprivacyframework.gov und trage das Ergebnis mit Datum in deine Transferprüfung ein. Die Standardvertragsklauseln im DPA gelten unabhängig davon.
Häufige Fragen zu Claude und Datenschutz
Ist Claude DSGVO-konform?
Ob Claude die Anforderungen der europäischen Datenschutz-Grundverordnung erfüllt, hängt von deinem Einsatz ab. Auch für deutsche Unternehmen ist Claude damit nicht automatisch rechtlich unbedenklich oder bedenklich: Es kommt auf Tarif und Konfiguration an. Die Sicherheitsstandards von Anthropic ersetzen deine eigenen Maßnahmen nicht. Mit Claude for Teams liefert Anthropic das Data Processing Addendum mit Standardvertragsklauseln und trainiert nicht mit deinen Daten[15][3]. Offen bleiben deine Aufgaben als Verantwortlicher: Rechtsgrundlage, Informationspflichten, Datenminimierung und die Dokumentation aus dem vorigen Abschnitt. Bei der Verarbeitung personenbezogener Daten Dritter gilt das umso mehr.
Werden meine Chats für das Training von KI-Modellen genutzt?
Bei Free, Pro, Max und Ultra entscheidest du selbst in den Datenschutzeinstellungen[2]. Bei Team, Enterprise und der API trainiert Anthropic laut Dokumentation nicht mit Code oder Prompts, es sei denn, du hast dich ausdrücklich für eine Datenweitergabe entschieden, etwa in einem Entwicklungspartner-Programm[3]. Eine Ausnahme bleibt das Feedback: Was du über /feedback schickst, wird fünf Jahre gespeichert.
Wo speichert Anthropic meine Daten?
Bei der Anthropic-API ist der Speicherort laut Dokumentation derzeit „us“, und die Berechnung läuft in „us“ oder „global“[9]. Wer die Berechnung in der EU will, nutzt Claude über Amazon Bedrock oder Google Vertex AI mit EU-Region, wie im Abschnitt zu Stufe 3 beschrieben.
Wer braucht einen AVV mit Anthropic?
Jeder, der personenbezogene Daten anderer Menschen, etwa von Kunden oder Mitarbeitenden, mit Claude verarbeitet. Für Consumer-Tarife gibt es keinen, im Team-Plan gilt das DPA automatisch als Teil der Commercial Terms[15]. Als Dienstleister trägst du Anthropic zusätzlich als Unterauftragsverarbeiter in deine eigenen Kundenverträge ein.
Was bedeutet der EU AI Act für den Einsatz von Claude?
Der EU AI Act, auf Deutsch KI-Verordnung, verlangt seit dem 02.02.2025 KI-Kompetenz von Unternehmen, die KI einsetzen[14]. Ob dein Einsatz zusätzlich in eine Risikokategorie fällt, hängt vom Anwendungsfall ab, nicht vom Modell. Marketing, Texte und Analysen sind etwas anderes als eine automatische Bewerberauswahl. Lass das im Zweifel prüfen.
Ist Claude datenschutzfreundlicher als ChatGPT oder Copilot?
Das kann ich seriös nicht beantworten, weil ich die Verträge der anderen Anbieter nicht geprüft habe. Das Raster funktioniert aber für jedes Tool: Welcher Tarif gilt, gibt es einen Auftragsverarbeitungsvertrag, wird mit meinen Daten trainiert, und wo werden sie verarbeitet? Wer diese vier Fragen für jeden Anbieter schriftlich beantwortet, hat den Vergleich.
Fazit
Claude lässt sich für normale Geschäftsdaten datenschutzkonform nutzen, wenn drei Dinge stimmen: der richtige Tarif mit AVV, ein paar bewusst gesetzte Schalter und weniger Daten im Kontext. Das kostet einen Nachmittag und 20 bis 25 USD je Platz. Absolute Sicherheit gibt es nur mit eigener Hardware, und die rechnet sich erst, wenn du mit Gesundheits-, Mandanten- oder vergleichbar sensiblen Daten arbeitest.
Die Dokumentation ist am Ende wichtiger als jede Einstellung. Ein Ordner mit AVV, Verarbeitungsverzeichnis, TOMs und Transferprüfung beantwortet die Fragen von Kunden und Konzern-IT, bevor sie gestellt werden.
Wenn du das nicht allein umsetzen willst: Im Kurs „Claude datenschutzkonform einrichten“ im Mitgliederbereich gehe ich jeden Schritt mit Screenshots durch, mit Vorlagen für Verarbeitungsverzeichnis, TOMs und Transferprüfung, der settings.json zum Kopieren und dem Anonymisierungsskript samt Skill. Für Teams, die Claude gemeinsam einführen, gibt es die PowerSession, in der wir dein Setup zusammen aufsetzen. Wie du Claude im Team organisierst, beschreibe ich im Artikel Claude im Team nutzen.
Alle Teile der Serie Claude Code:
Leitfaden-Serie
- Claude Code: Was es ist und wie du es nutzt (Leitfaden)
- Claude Code installieren und einrichten: die Anleitung
- Claude Code Kosten 2026: Preis, Abo, Limits und API
- Claude Code Skills: die besten für Entwickler
- Codex vs. Claude Code: Gemini CLI, Copilot und Cursor im Vergleich
- Claude datenschutzkonform nutzen: DSGVO-Leitfaden (dieser Beitrag)
- Claude im Team nutzen: Team-Plan, Enterprise und Setup
Aus der Praxis
- Agentic SEO Systeme 2026: Claude Code als SEO-Schaltzentrale
- Agentic Engineering: 100+ SEO-Projekte allein mit KI
- Claude Skills in der Praxis: Peec AI MCP Challenge
- Onlineshop mit Claude Code bauen: Happy Coffee
Studien
- KI-Halluzinationen: Was DELEGATE-52 für Unternehmen zeigt
- Wie LLMs Marken ranken: eine statistische Studie
Be Ahead Newsletter
Quellen
- Anthropic: Claude Pricing, abgerufen am 01.11.2026
- Anthropic: Updates to Consumer Terms and Privacy Policy, 28.08.2025, abgerufen am 01.11.2026
- Offizielle Dokumentation: Data usage, abgerufen am 01.11.2026
- Offizielle Dokumentation: Configure permissions, abgerufen am 01.11.2026
- Claude Platform Docs: Pricing, abgerufen am 01.11.2026
- Claude Platform Docs: Claude in Amazon Bedrock, abgerufen am 01.11.2026
- Offizielle Dokumentation: Claude Code on Amazon Bedrock, abgerufen am 01.11.2026
- Offizielle Dokumentation: Claude Code on Google Vertex AI, abgerufen am 01.11.2026
- Claude Platform Docs: Data residency, abgerufen am 01.11.2026
- Hetzner: Dedicated GPU-Server, Preise netto, abgerufen am 01.11.2026
- Mistral AI: Pricing, abgerufen am 01.11.2026
- Mistral AI auf Hugging Face: Devstral Small 2507, abgerufen am 01.11.2026
- Qwen auf Hugging Face: Qwen3-Coder-30B-A3B-Instruct, abgerufen am 01.11.2026
- Europäische Kommission: AI Literacy, Questions & Answers, abgerufen am 01.11.2026
- Anthropic: Data Processing Addendum, abgerufen am 01.11.2026
- Offizielle Dokumentation: Server-managed settings, abgerufen am 01.11.2026
- Offizielle Dokumentation: Zero data retention, abgerufen am 01.11.2026
- Eigene Gespräche mit Kunden und Interessenten, Juni bis Oktober 2026, Transkripte lokal, anonymisiert
- Eigene Einrichtung des Team-Plans und des Arbeitsplatzes am 01.11.2026: Admin-Einstellungen, verwaltete Einstellungen, Anonymisierungsskript, Datenschutz-Dokumentation
Visibly AI: dein SEO-Copilot
Projekte, Rankings, Search-Console-Daten und ein Copilot, der die Analyse für dich macht. Kostenlos starten.
Über den Autor: Antonio Blago
SEO Freelancer & AI Visibility Experte
Ich optimiere SEO datengetrieben mit Python, Verkaufspsychologie und meinem Neuro-SEO System®. Auf YouTube, LinkedIn und Instagram teile ich regelmäßig praxisnahe Anleitungen, Insights und aktuelle SEO-Tricks.