RAG, Fine-Tuning oder Prompt? Das richtige KI-Wissen

KI-Zusammenfassung
- Sprachmodelle halluzinieren, weil sie das nächste Wort vorhersagen und firmeneigenes Wissen nie in ihrem Training sahen, weshalb Firmenwissen gezielt ins Modell muss.
- RAG ist der Standardweg für häufig wechselndes Firmenwissen, das belegt werden muss und bei dem Nutzer unterschiedliche Zugriffsrechte haben.
- Prompt Engineering kostet am wenigsten und ist der erste Schritt, RAG folgt bei großen Wissensbeständen, Fine-Tuning ist der letzte Schritt für Stil und Format mit mindestens 50 bis 100 Beispielen.
- Zahlen und Live-Daten gehören nicht zu RAG, sondern werden per SQL aus der Datenbank oder per API abgerufen und nur vom Modell formuliert.
Automatisch mit KI erstellt, die Details stehen im Artikel.
Inhaltsverzeichnis
Du willst online Laufschuhe bestellen und fragst vorher den Chatbot im Shop, ob der Schuh eher groß oder klein ausfällt. Die Antwort lautet: eher groß. Also bestellst du eine Nummer kleiner, das Paket kommt, und der Schuh drückt. Der Chatbot hat in diesem Moment geraten. Der Shop hat ihm nie die Angaben mitgegeben, die er gebraucht hätte: die genauen Maße, die Passform und das Feedback anderer Kunden.
Dieser Artikel gehört zu meiner YouTube-Reihe „Daten für KI“ und ist die schriftliche Fassung von Folge 1. Er beantwortet die Frage, die vor jedem KI-Projekt steht: Wie kommt das Wissen deiner Firma in ein Sprachmodell, per Prompt, per RAG oder per Fine-Tuning? Am Ende hast du sechs Punkte und vier Ja-Nein-Fragen, mit denen du das für deinen eigenen Fall entscheidest.
Der Test: Ein Chatbot rät, und er klingt dabei sicher
Für das Video habe ich mir einen fiktiven Laufschuh-Shop ausgedacht. Er heißt Sprintwerk, der Schuh heißt Tempo 2. Dazu liegen sechs Dokumente vor: Produktseite, Preisliste, Größen und Passform mit Innenlängen, Rückgabe, FAQ und Kundenbewertungen. Als Sprachmodell läuft qwen2.5:3b lokal über Ollama auf meinem Rechner.
Die Antwort ohne Shopdaten
Ich frage das Modell: „Fällt der Laufschuh Tempo 2 von Sprintwerk groß oder klein aus?“ Den Shop gibt es nicht, das Modell kann ihn also nicht kennen. Trotzdem kommt sofort eine Antwort: Der Schuh falle größer aus und sei speziell für Sprinter gebaut. Das klingt überzeugend und ist komplett erfunden. Die Antwort steht hier unverändert.
Dieselbe Frage mit RAG
Danach stelle ich dem gleichen Modell die gleiche Frage noch einmal, diesmal mit RAG in Open WebUI. Bevor das Modell antwortet, durchsucht das System die Dokumente der Sammlung „Sprintwerk Shop“ und gibt ihm die passenden Stellen mit. Jetzt lautet die Antwort: „Der Laufschuh Tempo 2 fällt eine halbe Nummer klein aus“, mit dem Rat, eine halbe Größe größer zu bestellen. Als Quelle nennt das System die Datei groessen_passform.md, drei Quellen wurden abgerufen.
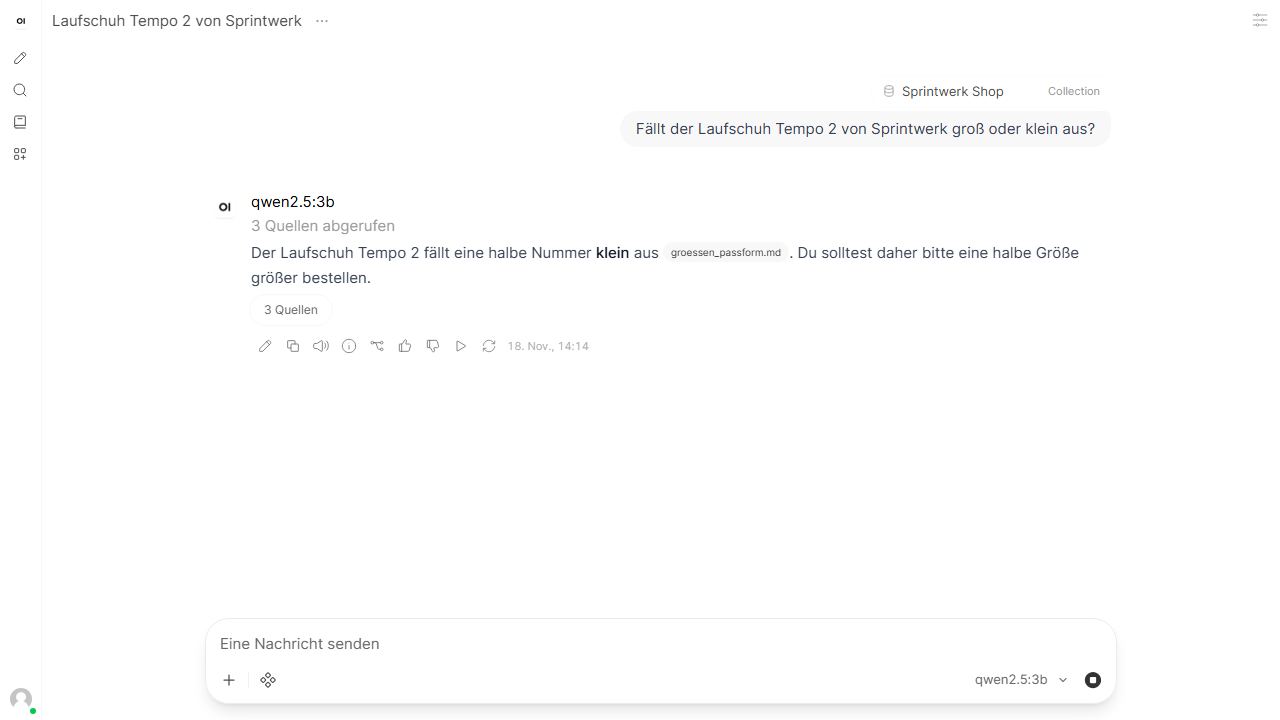
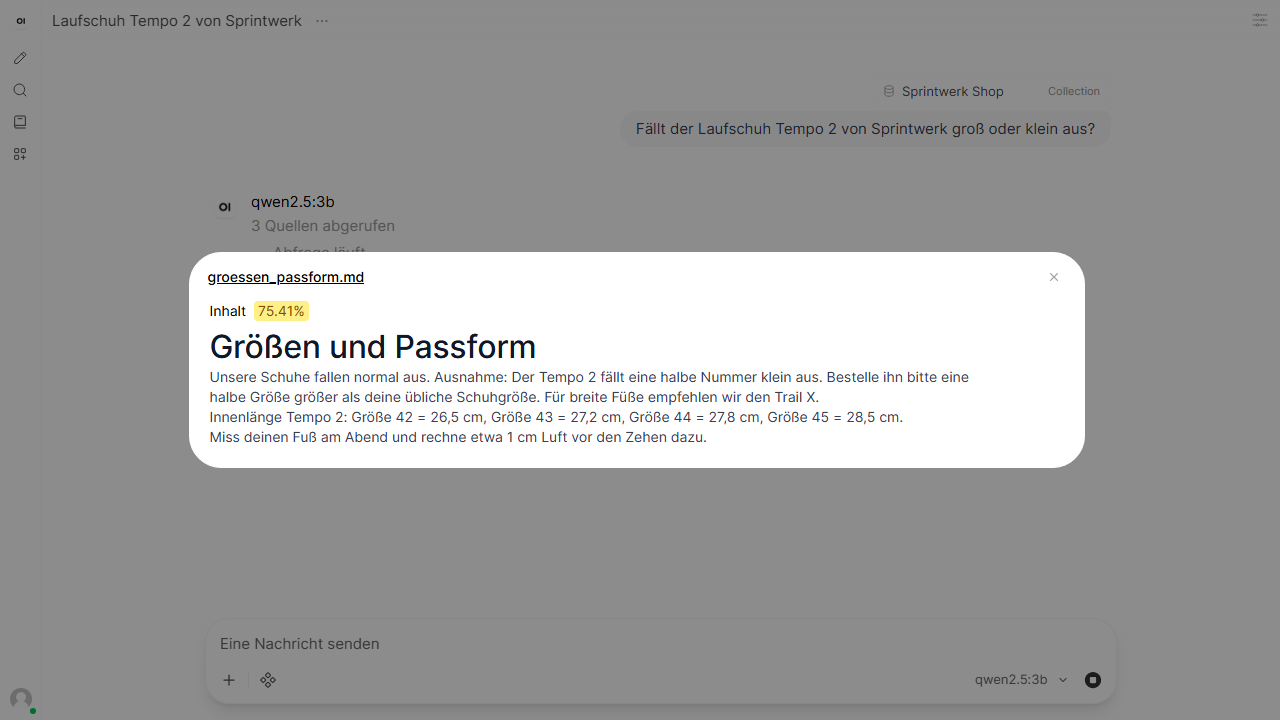
Das Modell ist in beiden Fällen dasselbe. Der Unterschied liegt allein in den Daten, die es zu sehen bekommt. Mit der ersten Antwort hättest du die falsche Größe bestellt, mit der zweiten die richtige.
Warum Sprachmodelle halluzinieren
Ein Modell sagt das nächste Wort voraus
Ein Large Language Model ist mit riesigen Textmengen trainiert und kann eine Sache wirklich gut: vorhersagen, welches Wort als Nächstes kommt. Was es dabei gelernt hat, steckt in Milliarden von Zahlen, den Gewichten. Es schlägt nichts nach, es formuliert, was plausibel klingt. Ob das stimmt, hängt davon ab, welche Daten es zu sehen bekommt.
Zwei Lücken, die jedes Modell hat
Daraus ergeben sich zwei Lücken. Was nach dem Trainingsstichtag passiert ist, kennt das Modell nicht. Und deine internen Dokumente waren nie im Training: die Passform deines Schuhs, deine Rückgabefrist, deine aktuellen Preise. Fragst du trotzdem danach, bekommst du oft eine Antwort, die plausibel klingt und falsch ist. Das nennt man Halluzination.
In einem Kickoff mit einem Industriekunden im Oktober 2026 kam dazu ein Punkt, den ich seitdem bei jedem Projekt nenne: Sprachmodelle erreichen nie hundert Prozent Genauigkeit. Wer eine Automatisierung baut, braucht deshalb eine Prüfung außerhalb des Modells, bei uns ein Skript mit Validator, das Fehler an das Modell zurückspielt, bis die Ausgabe stimmt. Für Firmenwissen heißt das: Es muss bei jeder Frage irgendwie mit ins Modell, und die eigentliche Frage ist nur, auf welchem Weg.
KI-Automation für SEO Workshop: Prompts, Agenten und APIs
Zwei Tage, in denen dein Team eigene KI-Agenten für SEO- und Content-Aufgaben baut: Prompt-Engineering, Custom GPTs und Copilot-Agenten, Keyword-Clustering, Content-Pipelines und Automatisierung über APIs. Jeder baut am Ende einen eigenen Agenten.
Jetzt erfolgreich AI Automation umsetzen
Zufriedene Kunden und Case Studies: ParocFOAMGLAS SchweizAlle Case Studies
Drei Wege zum richtigen Wissen: Prompt, RAG, Fine-Tuning
Dafür gibt es drei Wege. Sie schließen sich nicht gegenseitig aus, die meisten Systeme kombinieren Prompting und RAG.
| Weg | So kommt das Wissen ins Modell | Stärke | Grenze |
|---|---|---|---|
| Prompt Engineering | Wissen und Regeln stehen direkt im Prompt | Wirkt sofort, keine zusätzliche Technik | Begrenzte Textlänge, jede Frage wird teurer |
| RAG | Das System sucht passende Textstücke und gibt sie mit | Aktuell, mit Quelle, Modell bleibt unverändert | Nur für Texte, Qualität hängt an den Daten |
| Fine-Tuning | Das Modell wird mit eigenen Beispielen nachtrainiert | Stil, Format und Fachsprache sitzen | Fakten lernt es unzuverlässig, bei neuen Daten neu trainieren |
Prompt Engineering: der erste Schritt
Beim Prompt Engineering schreibst du Wissen und Regeln direkt in den Prompt. Deine Rückgaberegel mit drei Sätzen passt da locker hinein. Das wirkt sofort. Die Grenze ist die Textmenge, die in einen Prompt passt, und jede Frage wird mit dem ganzen Text auch teurer. Für mich ist Prompting immer der erste Schritt, weil es wenig kostet und schnell zeigt, was noch fehlt.
RAG: suchen, ergänzen, antworten
RAG steht für Retrieval-Augmented Generation. Retrieval heißt, das System sucht die passenden Textstücke heraus. Augmented heißt, diese Stücke kommen mit in den Prompt. Bei der Generation soll das Modell nur daraus antworten und die Quelle nennen. Das Modell selbst bleibt unverändert. Im Schuh-Beispiel sind es sechs Dokumente. Bei zweitausend Produktseiten passt das nicht mehr in einen Prompt, und genau dann holt RAG nur die Stellen heraus, die zur Frage passen.
Fine-Tuning: verändert vor allem das Wie
Beim Fine-Tuning trainierst du das Modell mit eigenen Beispielen nach. Damit änderst du vor allem Stil, Format und Fachsprache, zum Beispiel, dass es im Ton deines Shops antwortet. Dass der Tempo 2 eine halbe Nummer klein ausfällt, lernt es eher unzuverlässig, und mit der nächsten Preisliste müsstest du wieder neu trainieren. Fine-Tuning ändert, wie das Modell antwortet. Wenn du Wissen hast, das sich ändert und das du belegen musst, ist RAG der Standardweg.
Wann du RAG brauchst
Ich schaue mir dafür sechs Punkte an:
- Es geht um firmeneigenes Wissen.
- Der Bestand passt nicht mehr in einen Prompt.
- Die Inhalte ändern sich.
- Quellen sind Pflicht.
- Nicht jeder Nutzer darf alles sehen.
- Später soll nachvollziehbar sein, woher eine Antwort kam, zum Beispiel für ein Audit.
Treffen zwei oder mehr Punkte zu, ist RAG meistens der richtige Weg. Den Rechtepunkt nehme ich besonders ernst. In einem Erstgespräch im Oktober 2026 beschrieb ein Unternehmen genau die Ausgangslage: Der Chatbot liefert generische Antworten, das Wissen liegt verteilt in Excel-Listen, der Warenwirtschaft und dem Ticketsystem, und ein Pilot soll mit Rechteebenen starten. Dort hängt der Erfolg auch daran, wer welche Dokumente überhaupt sehen darf.
Wann du kein RAG brauchst
Genauso wichtig ist die Gegenseite. RAG ist stark bei Texten, für andere Datenarten gibt es bessere Werkzeuge:
- Ein einzelnes Dokument packst du direkt in den Prompt.
- Umsätze und Kennzahlen fragst du per SQL aus der Datenbank ab.
- Den Lagerbestand, etwa ob der Tempo 2 in Größe 44 verfügbar ist, holst du live über eine API oder per MCP.
- Rechnen und Summieren übernimmt normaler Code.
- Stil und Tonalität bekommst du am Anfang mit ein paar Beispielen im Prompt.
Bei Zahlen sehe ich das ständig. In meinem Podcast erzählte mir ein Gast, dass ihm dieselbe SEO-Schnittstelle im selben Chat für dasselbe Keyword einmal ein Suchvolumen von rund zwanzigtausend und einmal von rund zweihundert lieferte. Zahlen gehören deshalb in eine Abfrage mit festem Ergebnis, und das Modell formuliert nur das Ergebnis aus.
So baue ich es auch in Visibly AI, meiner eigenen SEO-Plattform: Zahlen liegen in einer klassischen Datenbank, Texte in einer Vektordatenbank für RAG. Beim Schuhshop wäre es dasselbe. Die Passform steht im Produkttext, die Stückzahl im Warenbestand, und jede Datenart bekommt ihr eigenes Werkzeug. Wie ich selbst Wissen für KI ablege, kannst du dir in meinem Open-Source-Projekt SkillMind ansehen, einem Gedächtnis für KI-Coding-Assistenten, das ebenfalls mit einer Vektordatenbank arbeitet (skill-mind.com).
Sechs typische Fälle und vier Fragen für deinen Fall
Sechs Fälle im Schnelldurchlauf
| Fall | Passender Weg |
|---|---|
| Service-Bot für Produkthandbücher | RAG |
| „Wie viel Umsatz hatten wir im Oktober?“ | SQL |
| Einen Vertrag zusammenfassen | Ganzer Text in den Prompt |
| Mails im Markenton beantworten | Erst Prompt, später vielleicht Fine-Tuning |
| „Ist Artikel 4711 auf Lager?“ | API |
| Interne Richtlinien mit Zugriffsrechten | RAG mit Rechtefilter |
Vier Ja-Nein-Fragen
- Ändert sich dein Wissen häufiger als einmal im Monat?
- Brauchen die Antworten eine Quelle?
- Brauchst du Rechte je Nutzer?
- Hast du 50 bis 100 geprüfte Beispiele?
Je öfter du bei den ersten drei Fragen Ja sagst, desto eher ist RAG der richtige Weg. Die vierte Frage gehört zum Fine-Tuning: Erst mit 50 bis 100 geprüften Beispielen lohnt sich überhaupt ein Blick darauf. Wenn du das für deinen Fall durchspielen willst, nimm dir fünf Datenquellen und geh die vier Fragen einmal durch. Nicht jede Quelle braucht RAG, und das siehst du dann auf einen Blick.
Fazit
Meine Reihenfolge ist klar: erst Prompting, dann RAG, dann Fine-Tuning. Prompting kostet am wenigsten und zeigt dir, was fehlt. RAG kommt dazu, sobald dein Wissen groß ist, sich ändert oder belegt werden muss. Fine-Tuning ist der letzte Schritt, wenn Stil und Format sitzen sollen und du geprüfte Beispiele hast. Zahlen und Live-Daten holst du über SQL oder eine API. In der nächsten Folge geht es um das, woran viele KI-Projekte hängen, die Daten selbst: Ich zeige an 62 Support-Tickets, wie du in zehn Minuten siehst, was in deinem Bestand schiefläuft. Weitere Hilfen zum Einrichten findest du bei den Skill-Sets.
Quellen: Eigene Gespräche mit Kunden und Interessenten sowie eigener Podcast, Oktober 2026, Transkripte lokal, anonymisiert. Demo: fiktiver Shop „Sprintwerk“ mit Beispieldaten, lokales Modell qwen2.5:3b über Ollama, RAG in Open WebUI.
Visibly AI: dein SEO-Copilot
Projekte, Rankings, Search-Console-Daten und ein Copilot, der die Analyse für dich macht. Kostenlos starten.
Zufriedene Kunden und Case Studies: Alle Case Studies
Über den Autor: Antonio Blago
SEO Freelancer & AI Visibility Experte
Ich optimiere SEO datengetrieben mit Python, Verkaufspsychologie und meinem Neuro-SEO System®. Auf YouTube, LinkedIn und Instagram teile ich regelmäßig praxisnahe Anleitungen, Insights und aktuelle SEO-Tricks.